Toute conversation sur l'IA cette année finit au même endroit. Le modèle n'est pas le goulot d'étranglement. Ce sont les données.
Les chiffres disent la même chose. Gartner prévoit que d'ici 2026, les organisations abandonneront 60% des projets d'IA qui ne sont pas soutenus par des données prêtes pour l'IA (Gartner, 2025). Un rapport de 2026 de Cloudera et Harvard Business Review Analytic Services a révélé que seulement 7% des entreprises estiment que leurs données sont entièrement prêtes pour l'IA, et seulement 23% ont une stratégie de données établie pour cela (Cloudera, 2026).
Au Notion Ambassadors Summit, des membres de l'équipe Notion ont décrit la direction du produit : Notion comme la Suisse de l'IA. Un foyer neutre pour le contexte de l'entreprise, où n'importe quel modèle (Notion AI, Claude, ChatGPT) peut travailler sur les mêmes informations. Certains l'ont appelé l'étoile du nord de Notion en ce moment.
Nous ne sommes pas sûrs que ce soit le bon pari. Le temps dira. Mais cela vient avec une condition : le contexte n'aide que s'il est organisé. Si votre workspace a trois bases de données clients, cinq versions du processus d'onboarding et que personne ne sait laquelle est la bonne, connecter l'IA ne fait que vous donner des réponses fausses plus vite.
Dire « il vous faut de bonnes données » est facile. Ce guide parle du comment : le processus que nous suivons avec les clients pour organiser et nettoyer les informations de l'entreprise afin que l'IA puisse les utiliser.
Ce que « prêt pour l'IA » signifie dans un workspace Notion
Pour la plupart des équipes, « prêt pour l'IA » ne signifie pas un data warehouse. Cela signifie que quand quelqu'un pose une question à l'IA sur l'entreprise, la réponse vient de la bonne source et vous pouvez vérifier d'où elle vient.
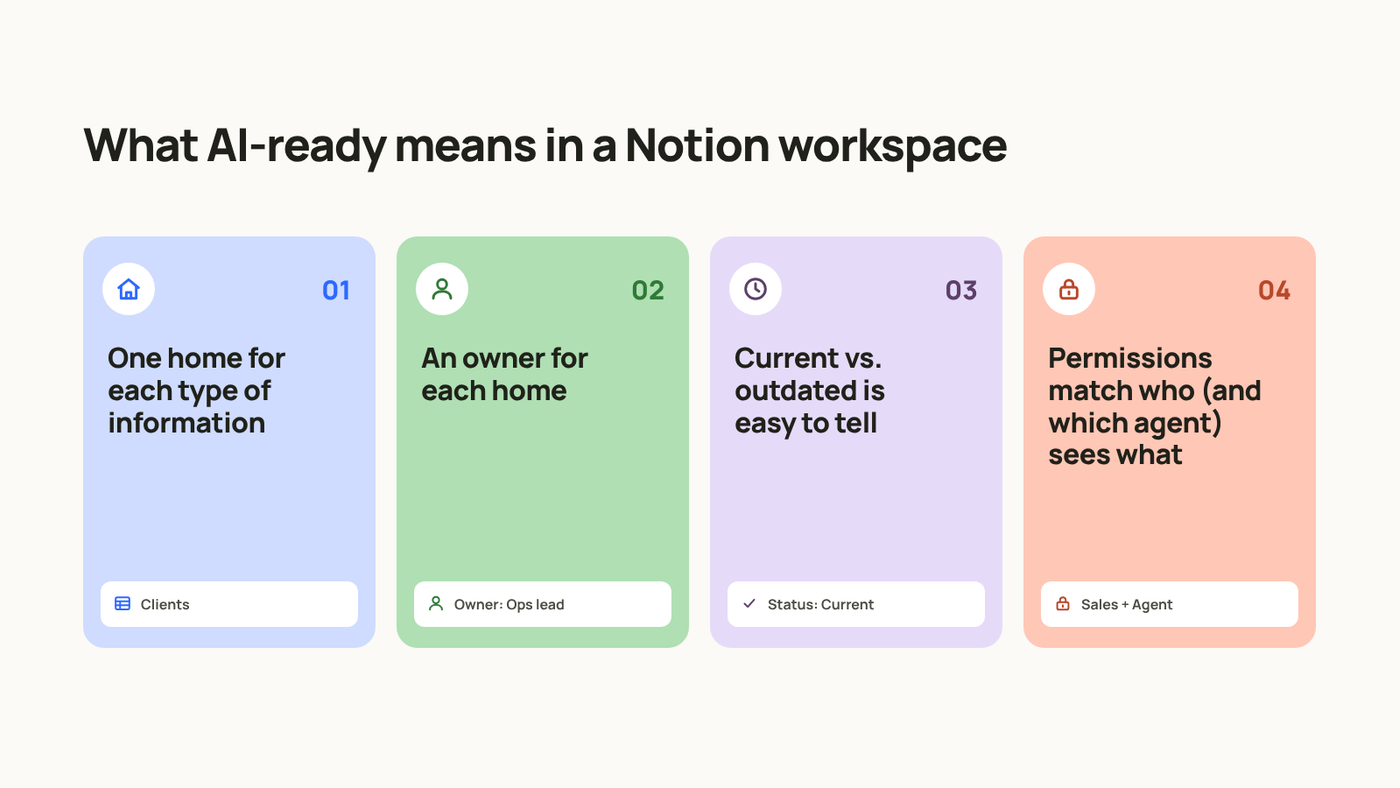
En pratique, cela demande quatre choses :
- Chaque type d'information a un seul foyer.
- Chaque foyer a un responsable.
- Il est facile de distinguer l'information actuelle de l'information obsolète.
- Les permissions correspondent à qui (et quel agent) doit voir quoi.
Un test simple : si un nouvel employé ne peut pas trouver la version actuelle d'un processus sans demander à quelqu'un, l'IA ne la trouvera pas non plus.
Étape 1 : Inventorier où vit l'information aujourd'hui
Avant de toucher à Notion, découvrez où l'information vit réellement. APQC a constaté que les travailleurs du savoir passent 2,8 heures par semaine à chercher ou demander de l'information. Ce temps va généralement dans les mêmes questions : où est la dernière version, qui l'a, laquelle est la bonne.
Allez département par département et notez, pour chaque type d'information, où elle vit aujourd'hui, qui la met à jour et à quelle fréquence. Par exemple :
- Contrats clients (Ventes) : dossier Google Drive, mis à jour par l'account manager, par affaire.
- Statut du projet (Delivery) : Notion et fils Slack, mis à jour par le project lead, chaque semaine.
- Factures (Finance) : outil comptable et tableur, mis à jour par la Finance, chaque mois.
- Processus et politiques (Opérations) : wiki Notion, certains dans Docs, mis à jour par personne en particulier, rarement.
Ceci est un exemple. Le vôtre sera plus long, et c'est le but. Le résultat habituel est la même information stockée à deux ou trois endroits, sans responsable clair. C'est exactement ce que l'IA trouvera en cherchant.
Étape 2 : Cartographier les flux de données entre départements
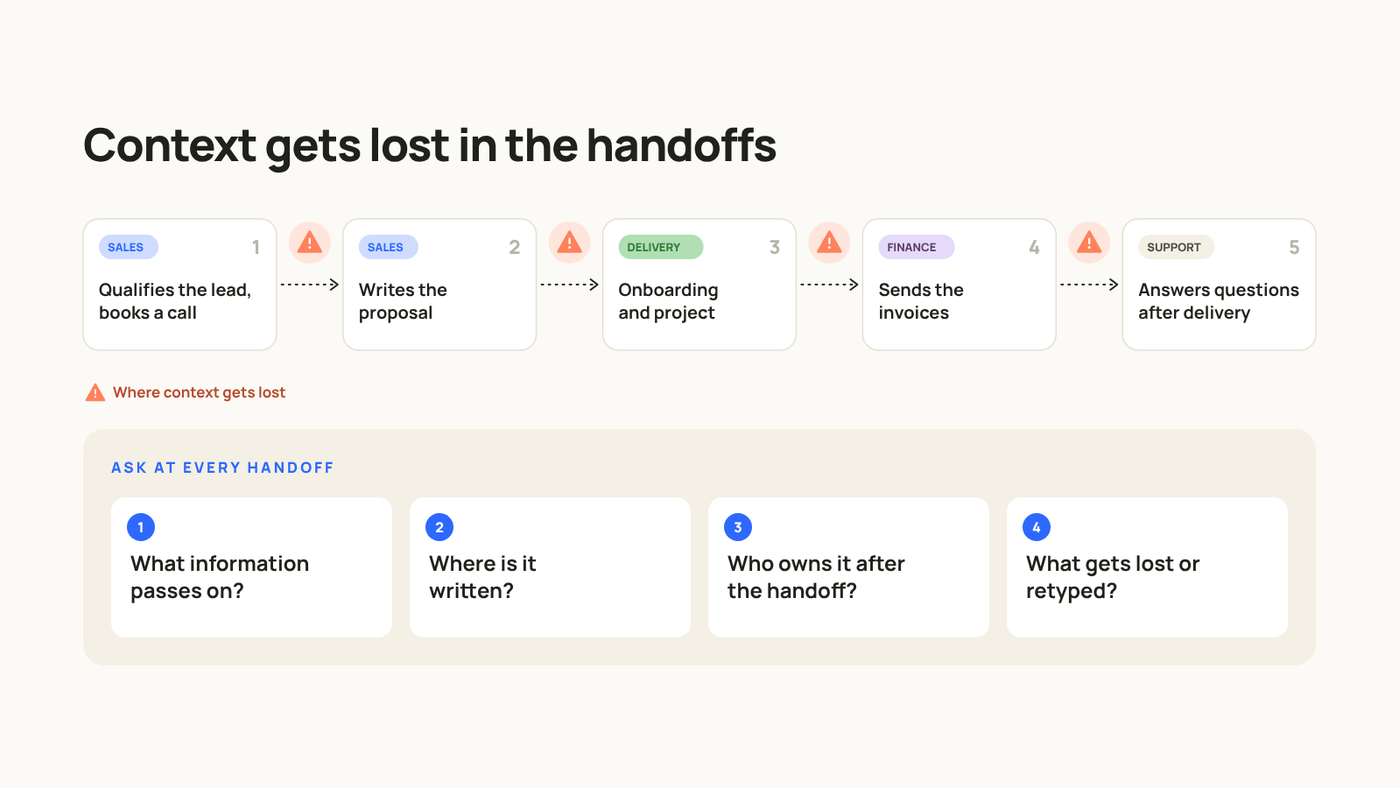
La plupart du contexte ne se perd pas dans un département. Il se perd dans les transitions entre eux.
Choisissez une entité et suivez-la du début à la fin. Un client est généralement le meilleur exemple :
- Les ventes qualifient le lead et planifient un appel.
- Les ventes rédigent la proposition.
- Delivery gère l'onboarding et le projet.
- La finance envoie les factures.
- Le support gère les questions après la livraison.
À chaque transition, posez quatre questions :
- Quelle information passe d'une équipe à la suivante ?
- Où est-elle écrite ?
- Qui en est responsable après la transition ?
- Qu'est-ce qui se perd ou se retape ?
Ensuite, décidez d'une source de vérité pour chaque entité centrale : clients, projets, tâches, documents, réunions. Écrivez la règle, y compris le moment où quelque chose passe d'un endroit à un autre.
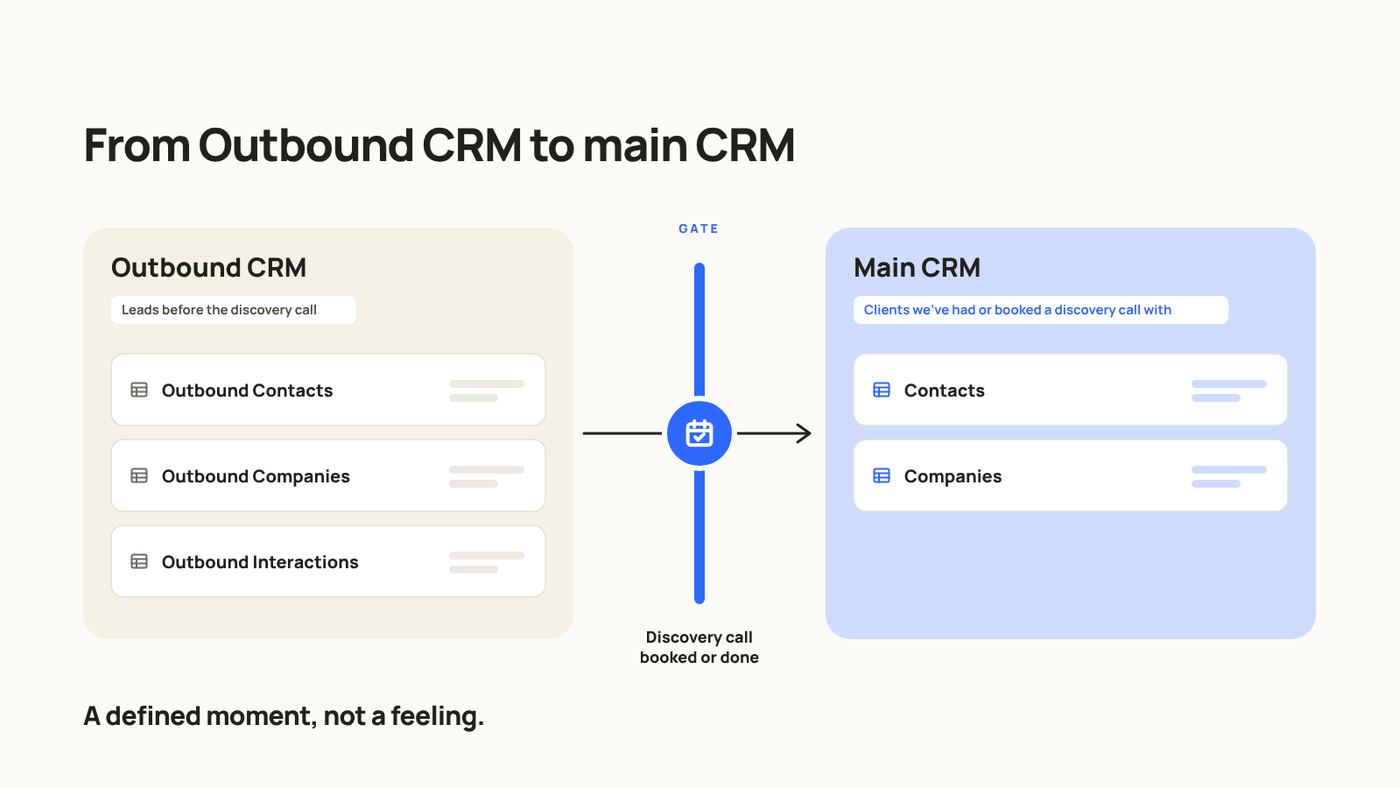
Un exemple de notre propre système : nous gardons les leads outbound et les clients du CRM dans des bases séparées, et nous avons défini exactement quand un lead passe dans le CRM (quand un appel de découverte est planifié ou terminé). Cette règle vit dans une page que l'équipe et nos agents lisent. Sans elle, la même entreprise se retrouverait dans les deux bases avec des données différentes.
Étape 3 : Concevoir un petit modèle de données
Une fois que vous connaissez les flux, concevez la structure. Gardez-la petite. La plupart des équipes travaillent bien avec quelques bases de données : tâches, projets, clients ou contacts, une base de connaissances et réunions.
Trois règles que nous suivons :
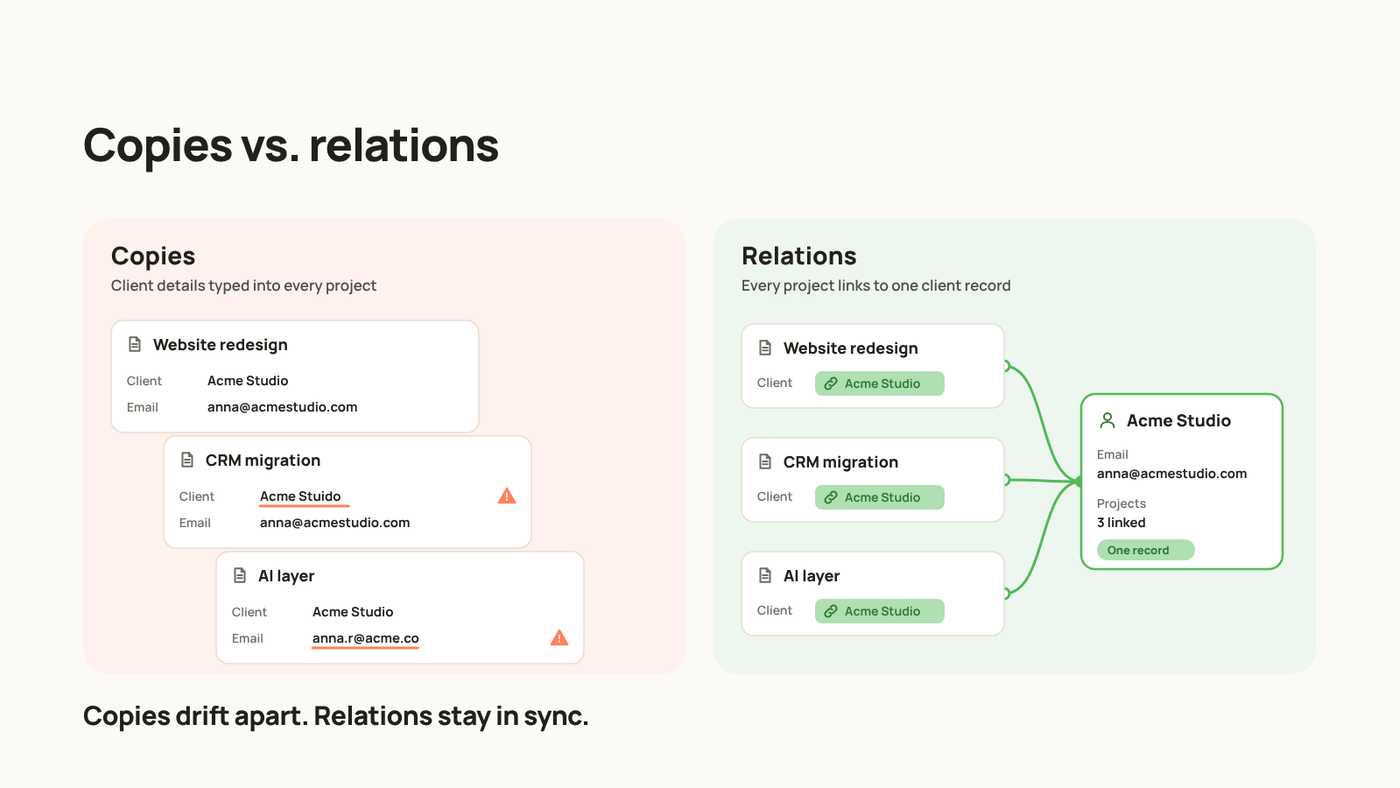
Des relations au lieu de copies. Si un projet appartient à un client, reliez le projet au client. Ne copiez pas le nom, l'email et les coordonnées du client dans le projet. Les copies se désynchronisent ; les relations restent synchronisées.
Une base de données par entité, des vues filtrées par équipe. Au lieu d'une base de tâches pour le Marketing et une autre pour les Ventes, utilisez une seule base de tâches avec une propriété Équipe et une vue pour chaque équipe. L'IA cherche alors à un seul endroit, et le reporting entre équipes fonctionne.
Un vocabulaire partagé. Les mots signifient des choses différentes selon les départements. Pour la Finance, un « client » peut être un compte signé. Pour les Ventes, ce peut être n'importe qui a planifié un appel. Écrivez une page de glossaire et utilisez les mêmes noms dans les bases de données, les propriétés et les options de select.
Remplissez aussi les descriptions des bases de données et des propriétés. Les gens les lisent quand ils hésitent, et l'IA les utilise pour comprendre ce qu'un champ signifie.
Étape 4 : Nettoyer avant de connecter
C'est l'étape que la plupart des équipes sautent, et celle qui fait la plus grande différence. Notre checklist de nettoyage :
- Fusionner les doublons. Une base de données par type d'entité. Déplacez les lignes, conservez les relations, puis supprimez ou archivez l'ancienne base.
- Archiver ce qui n'est plus actuel. Projets terminés, anciennes versions, pages que personne n'a ouvertes depuis des mois. Si une page n'a pas été ouverte depuis trois mois, revoyez-la ou archivez-la.
- Standardiser les propriétés. Les mêmes options de select partout, un champ de date par signification, des selects au lieu de texte libre quand c'est possible.
- Supprimer les propriétés vides. Si personne ne la remplit, elle a besoin d'un responsable ou elle doit disparaître.
- Marquer ce qui est fiable. Utilisez la vérification de page sur les processus et politiques qui sont approuvés et à jour, pour que les gens et l'IA puissent les distinguer des brouillons.
- Ajouter un responsable et une date de revue à chaque base de données et section de wiki clé.
L'ordre compte. Commencez par l'information sur laquelle les gens demanderont le plus à l'IA, pas par le coin le plus ancien du workspace.
Étape 5 : Établir une gouvernance pour que ça reste propre
Les données propres ne restent pas propres toutes seules. Trois choses les maintiennent ainsi :
Des responsables. Chaque base de données et section de wiki a une personne responsable. Pas une équipe, une personne.
Un rythme de revue. Une revue mensuelle ou trimestrielle courte des bases principales : ce qui est obsolète, ce qui est dupliqué, ce que personne n'utilise. Quand un processus change, le responsable met à jour la page source, pas un message Slack.
Des permissions au bon niveau. L'accès aux pages décide qui peut ouvrir une page. L'accès aux propriétés décide ce que les gens peuvent voir ou éditer à l'intérieur, et les agents peuvent avoir leurs propres permissions. Nous avons couvert cela plus en détail dans une newsletter récente sur l'accès au niveau des propriétés. La règle générale : donnez à chaque personne et chaque agent l'accès à ce dont leur travail a besoin, et rien de plus.
Étape 6 : Rendre le contexte lisible pour l'IA
Avec une structure propre, quelques étapes supplémentaires aident l'IA à donner de meilleures réponses :
- Écrivez une page de standards IA. Listez vos sources de vérité (« quand on parle de clients, la source est cette base de données ») et les règles que l'IA doit suivre, comme ne pas créer de nouvelles bases ou vérifier avant d'écrire. Nous gardons la nôtre comme un Skill et la référençons depuis les instructions de nos agents.
- Ajoutez des propriétés de résumé. Un résumé AI Autofill sur les notes de réunion ou les enregistrements du CRM donne à l'IA une version courte et cohérente de chaque page avec laquelle travailler.
- Limitez l'accès des agents par workflow. Un agent qui écrit des emails de suivi n'a pas besoin d'accéder à la paie.
- Testez avec des questions réelles. Écrivez dix questions que votre équipe pose chaque semaine. Demandez à l'IA. Vérifiez si chaque réponse pointe vers la bonne page. Chaque réponse incorrecte vous montre un manque dans la structure.
Le dernier point est le plus utile. Il transforme « nos données sont-elles prêtes ? » en une liste concrète de choses à corriger.
FAQ
Faut-il tout nettoyer avant d'utiliser l'IA ?
Non. Commencez par un département ou un workflow, celui où les gens posent le plus de questions. Nettoyez-le, testez-le, puis passez au suivant.
Faut-il tout déplacer dans Notion ?
Pas nécessairement. Notion AI peut chercher dans des outils connectés comme Google Drive ou Slack. Ce qui compte, c'est que chaque type d'information ait un foyer défini et que tout le monde sache lequel.
L'IA peut-elle aider avec le nettoyage ?
Oui, pour les tâches répétitives : étiqueter, résumer, remplir des propriétés, signaler des doublons probables. Décidez de la structure d'abord, puis laissez l'IA aider à l'appliquer.
Que se passe-t-il si on change de modèle d'IA plus tard ?
C'est l'avantage d'organiser le contexte dans un endroit neutre. La structure, les sources de vérité et les permissions restent. Le modèle au-dessus peut changer.
Combien de temps cela prend-il ?
Cela dépend de la quantité d'information et du nombre d'outils impliqués. Nous le planifions généralement département par département pour que l'équipe voie des résultats rapidement.
Comment nous pouvons aider
Vous pouvez faire tout ce qui est dans ce guide par vous-même. Cela prend juste du temps, et entre en concurrence avec le travail que votre équipe a déjà dans ses priorités.
Si vous n'avez pas les heures pour cartographier les flux, redessiner les bases de données et nettoyer des années de pages, ou si vous préférez que quelqu'un qui a déjà fait cela avec d'autres équipes regarde votre workspace avec un regard neuf, c'est là que nous intervenons. Chez noxen studio, nous cartographions vos flux de données, concevons le modèle de données dans Notion et nettoyons le workspace pour que l'IA puisse travailler dessus.
Réservez une Discovery Call et nous regarderons votre cas.